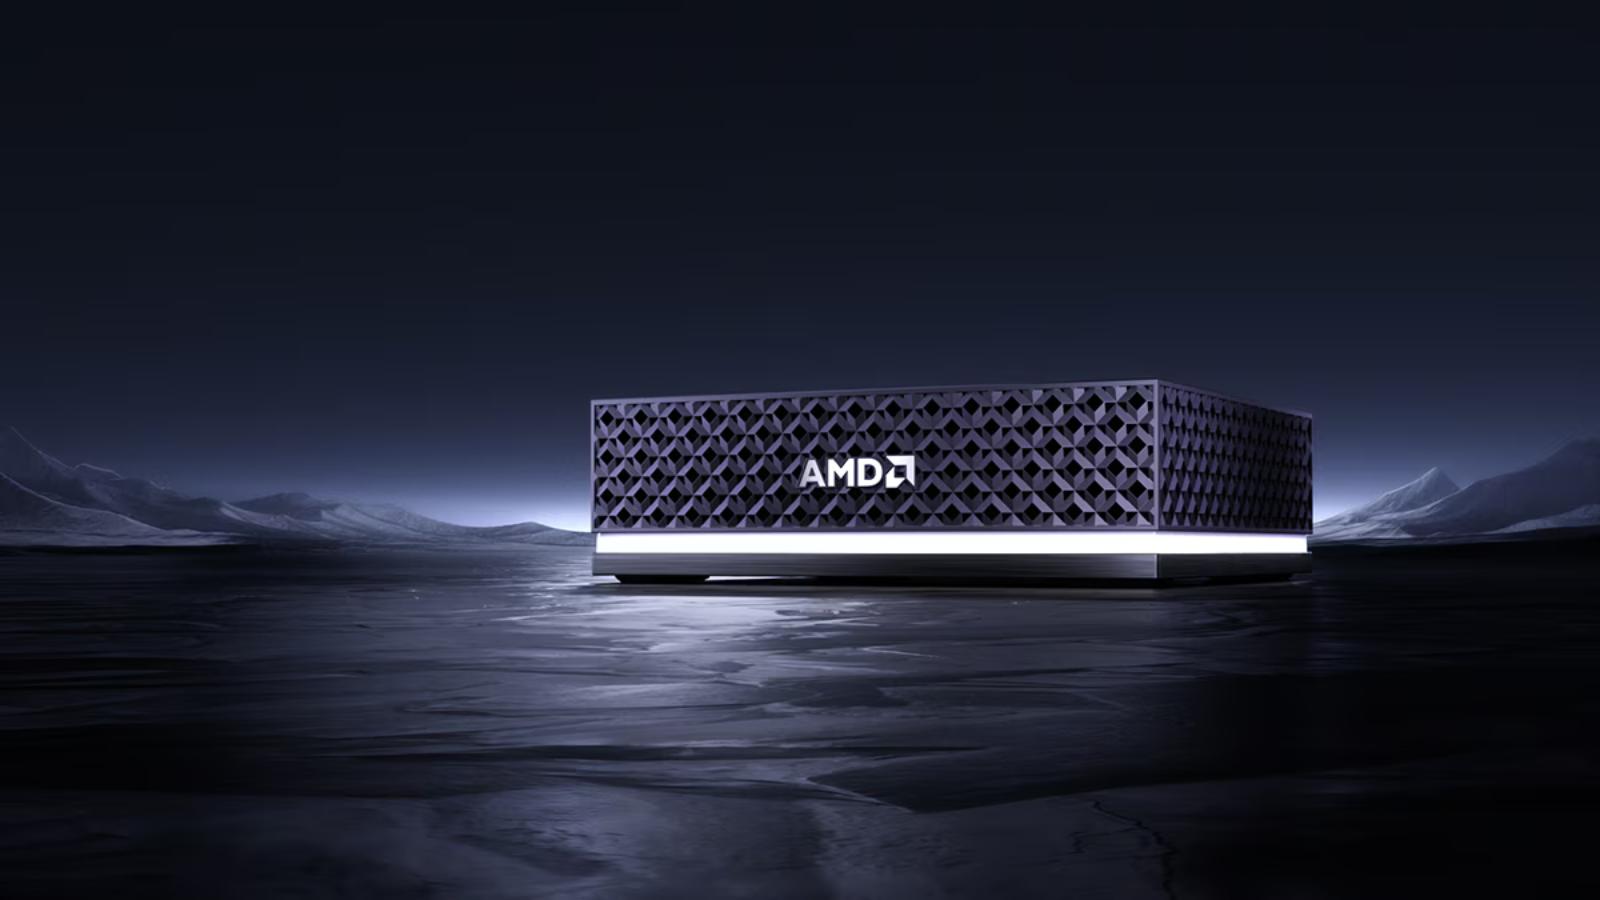
AMD comenzó a ofrecer en Micro Center la plataforma de escritorio compacta Ryzen AI Halo, orientada a desarrolladores que buscan ejecutar inteligencia artificial (IA) personal y computación agéntica de forma local. La propuesta apunta a reducir la dependencia de la nube y a sostener cargas de trabajo que combinan inferencia, orquestación y validación dentro del equipo.
La línea está impulsada por procesadores de hasta el AMD Ryzen AI Max+ PRO 495. En su configuración de mayor capacidad, la plataforma incorpora hasta 192 GB de memoria unificada y permite asignar hasta 160 GB a gráficos, con el objetivo de mantener en memoria modelos, aplicaciones y datos de trabajo en simultáneo. En ese esquema, la compañía plantea que el sistema habilita la ejecución de modelos de hasta 300.000 millones de parámetros y la gestión de flujos de trabajo multiagente desde el escritorio.
De asistentes a agentes
El enfoque de Ryzen AI Halo se apoya en una transición en los usos de IA: “La IA está evolucionando de asistentes que generan respuestas hacia agentes que coordinan herramientas, trabajan entre aplicaciones y completan tareas de varios pasos”. En ese marco, estas tareas demandan algo más que velocidad de inferencia: requieren capacidad de CPU para orquestación, cómputo acelerado para IA y memoria suficiente para sostener el contexto de trabajo.
Ryzen AI Halo se comercializa en dos configuraciones principales con distintos niveles de memoria y capacidad de modelos. La versión con Ryzen AI Max+ 395 parte de US$ 3.999,99 e incluye hasta 128 GB de memoria unificada, con soporte para modelos de hasta 200.000 millones de parámetros. La variante con Ryzen AI Max+ PRO 495 parte de US$ 7.299,99 y amplía la memoria unificada hasta 192 GB, con el foco puesto en sumar margen para modelos, aplicaciones y contexto de trabajo activo.
Además de los equipos Ryzen AI Halo, se mencionan otros sistemas equipados con procesadores de la Serie Ryzen AI Max 400, como HP ZBook Ultra G3A, Framework Desktop y GMKtec EVO-X5 PRO.
Cómo medir el rendimiento de IA local
En paralelo, AMD difundió criterios para evaluar sistemas de IA local. El documento propone que métricas como tokens por segundo y tiempo hasta el primer token siguen siendo útiles, pero sugiere incorporar variables como la calidad del resultado, la capacidad de memoria y la ejecución completa del flujo de trabajo.
Entre los puntos recomendados figuran comparar resultados junto con la velocidad de finalización; evaluar la carga de trabajo que un sistema puede sostener en el dispositivo con distintas longitudes de contexto; y medir cómo se ejecutan y coordinan agentes concurrentes. También se sugiere desglosar el tiempo total de finalización para distinguir la inferencia del modelo de otras etapas como orquestación de CPU, recuperación de información, operaciones con archivos, uso de herramientas y validación.